J9一触即发:加速算力芯片敏捷仿真与硅基落地
融合云原生异构超算算力与EDA仿真加速核心,实现从系统级架构探索、自定义扩展指令集(ISA)协同验证,到张量编译器自动调优的全栈设计贯通。平台攻克互联拓扑带宽墙与动态功耗收敛难题,助力半导体研发团队实现硅前软硬件精准对齐,大幅缩减芯片迭代周期。
import chip_sim_core as csc
# 初始化系统拓扑与片上互联网络 (NoC)
soc = csc.SystemMesh(grid_x=8, grid_y=8, protocol="CXL_3.0")
soc.attach_accelerator(core_type="TensorCore_V4", count=64)
# 注入大模型算子权重分布与时钟精确模拟
workload = csc.WorkloadEngine.load_trace("transformer_flash_attn_bf16")
metrics = soc.run_cycle_accurate(workload, trace_depth=1000000)
print(f"IPC Gain: {metrics.ipc_gain}x | Memory Bound: {metrics.latency_ns}ns")
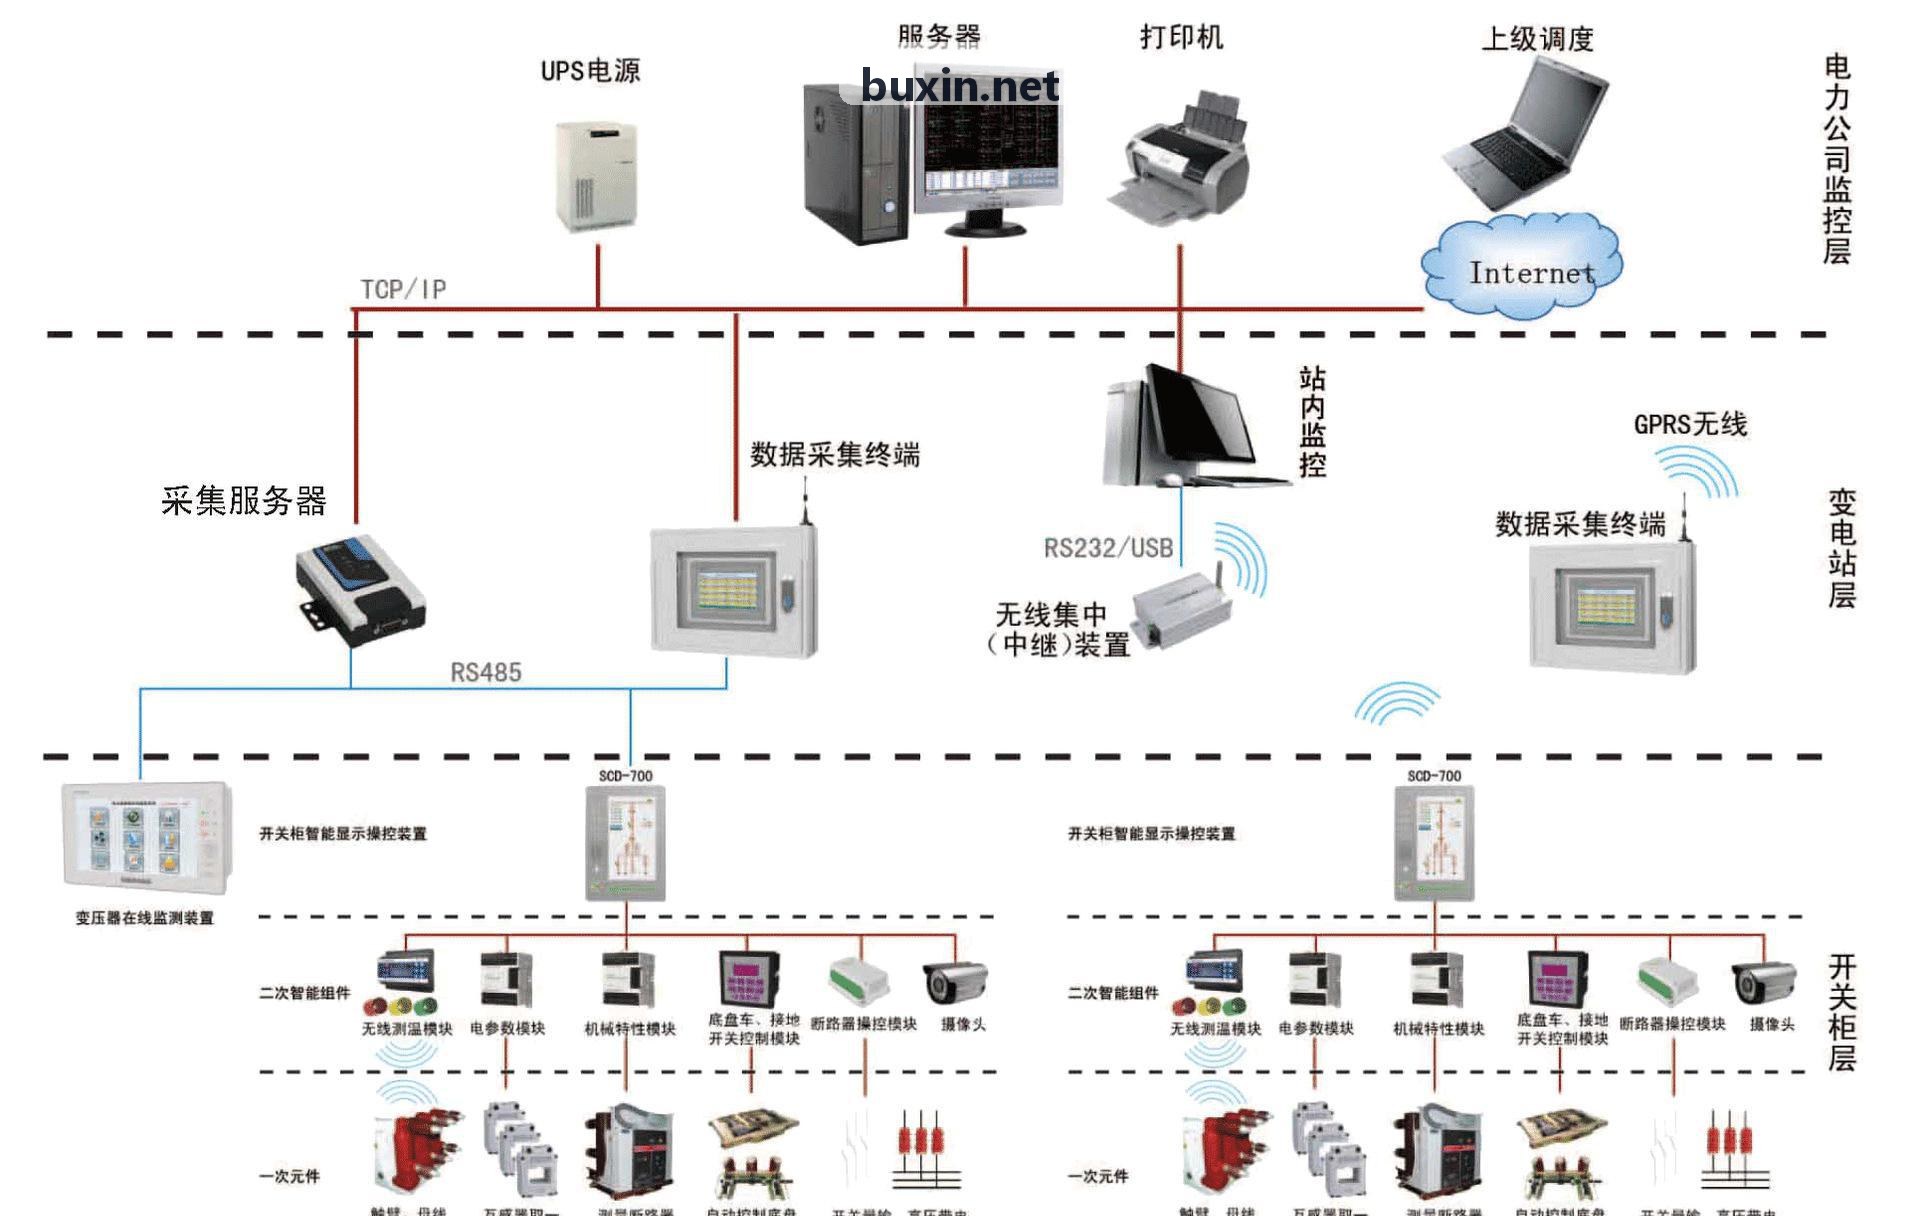
EDA敏捷仿真与底层系统架构深度对齐
传统芯片设计受限于软件团队必须等待流片返回才能开展驱动适配的阻隔。本平台通过高抽象级硬件模型,构建从虚拟硅片到运行时运行库的软硬件协同设计(Co-Design)通道。
-
01
架构早期探索与算力空间剪枝
在 RTL 编码前快速完成计算阵列规模、SRAM 缓存配比以及 NoC 带宽的吞吐模拟评估,规避硬件设计死锁缺陷。
-
02
指令集定制与微架构仿真验证
无缝支持 RISC-V 矩阵及向量指令扩展,自动生成匹配的汇编工具链、函数库仿真器与周期精确行为级模型。
-
03
全栈编译与算子自动卸载调度
内置对接底层张量加速内核的代码编译器,在流片前实现上层主流算子对自研硬件原语的高效对齐与行为等价测试。
破除物理算力瓶颈的6大核心工程支柱
以工程化手段化解超大模型落地所带来的高密计算、传输拥塞与功耗收敛挑战。
大规模分布式硬件仿真
支持多节点云端弹性调度集群,实现亿级等效逻辑门电路的高并发并行验证,大幅压缩单次回归测试耗时。
编译算子图层自动化调优
基于硬件微架构自适应重写计算计算图,实现循环展开、算子融合与片上显存驻留排布的全自动化策略搜索。
先进互联拓扑精准建模
精确还原 PCIe 5.0、CXL 以及专有高速 SerDes 互联信道行为,精准测算跨片通信吞吐与拥塞丢包率。
硅前功耗与电源完整性预测
结合实际网络模型负荷轨迹,快速推演动态功耗峰值与局部热点分布,保障前端逻辑设计的热设计功耗(TDP)可控。
软硬件等价协同调试探针
集成波形捕捉、寄存器追踪与运行时变量观测,软件工程师无需硬件探针即可准确定位硬件挂死缺陷根因。
物理工艺库与良率预测
对接主流晶圆代工厂主流工艺节点物理库,在早期阶段提供关键路径延迟估计与可制造性设计(DFM)分析建议。
全栈式 AI 芯片研发平台工具矩阵
模块化分层解耦体系,提供面向数字前端、编译器工程师与架构师的专属工作台。
敏捷架构设计工作台
专为芯片架构团队研发的轻量化系统探索环境,支持通过 Python/C++ 快速搭建计算拓扑并输出性能预测报表。
- 支持 RISC-V 矩阵扩展规范
- 无缝集成片上网络(NoC)延迟模拟
- 一键导出 SystemC / RTL 脚手架代码
超算级仿真编译器引擎
承接超大规模 RTL 网表的高吞吐软仿真调度器,具备内存感知与指令重排序优化能力,支持混合精度行为级调试。
- 门级吞吐量突破 120M Gates/s
- 支持 IEEE 1500 测试包装环协议
- 多核异构集群分布式并发调度
运行时验证与部署套件
打通主流深度学习框架到底层硬件驱动的桥梁,使算子研发团队能够在虚拟靶场中完成端到端推理性能跑分。
- 自动生成高效算子内核代码
- 显存分配与流水线冲突可视化分析
- 提供标准 OpenCL / Vulkan 驱动适配桩
攻克内存墙与通信墙的软硬件协同方法论
随着模型参数规模跃升至千亿级,传统冯·诺依曼架构面临严峻的搬运能耗瓶颈。J9一触即发不仅重构电路仿真加速链路,更将片上近存计算、脉动阵列数据流映射与动态稀疏化技术固化为可复用的数字验证标准。
查看底层拓扑演示近存数据流映射
将权重驻留机制与片上分布式 SRAM 紧密结合,仿真测算搬运能耗降低比率。
动态结构化剪枝
在硬件指令层引入非零元素寻址逻辑,消除无效矩阵乘法运算功耗开销。
非对称位宽支持
支持 FP8、INT4 与混合浮点微缩仿真,平衡计算吞吐与收敛损失误差。
可信验证流水线
全链路遵循功能安全与芯片容错验证规范,确保硅上运行稳定性。
全域覆盖的硅基验证与开发靶场
针对不同能效等级与算力密度的半导体产品线,提供量身定制的工程支持体系。
云端超大规模训练芯片
支撑高位宽矩阵计算卡与全互联机架拓扑的系统级模拟,精准推演多机多卡通信时的时延抖动分布。
高安全自动驾驶 NPU
满足汽车电子严苛的确定性时延要求,针对多路传感器融合感知算子进行严密的流水线阻塞排查与容错审计。
边缘端高能效视觉芯片
聚焦毫瓦级微功耗预算场景,快速探索专用定点量化硬件原语与休眠唤醒逻辑,保障芯片续航竞争力。
通用异构 GPGPU 架构
提供完整的单指令多线程(SIMT)模型构建能力,打通图形渲染与通用通用算力双轨调优的调试闭环。
实时交互调试与片上状态遥测
直观观测虚拟处理核心的指令吞吐、显存带宽占用与热力梯度波动。
void monitor_mesh_cluster(MeshCluster* cluster) {
while(cluster->is_active()) {
float tdp = cluster->read_thermal_gradient();
if (tdp > TDP_THRESHOLD_WATTS) {
cluster->throttle_frequency(SCALE_DOWN_15_PERCENT);
cluster->emit_telemetry_trace("HOTSPOT_ALERT_QUAD_3");
}
cluster->sync_pipeline_cycles();
}
}
标杆设计机构的硅基落地历程
真实芯片设计团队借助平台完成从原型验证到首发流片成功的工程突破。
国内顶尖算力设计院:千亿参数大模型加速卡验证
面临百亿级门电路互联拓扑复杂、多算子协同仿真耗时极长的挑战。通过平台部署大规模并行仿真引擎,全面打通编译工具链与底层微架构的时钟精确对齐流程。
智能车载芯片先锋企业:ASIL-D 级别确定性时延攻坚
车载实时多传感器融合算法对时钟周期与异常保护提出苛刻指标。利用平台的软硬件协同探针,提前半年在虚拟环境中跑通完整系统内核与深度学习模型底座。
弹性适配不同规模团队的交付规格
无论是高校科研团队验证前沿算子,还是企业级团队攻关规模化芯片,均可随需选型。
敏捷探索版
适用于高校课题组、初创团队进行轻量化微架构评估与算子原型验证。
- 支持 10M 门级以下逻辑规模仿真
- 标准 RISC-V 扩展指令集调试器
- 5 个云端并行测试流水线节点
- 社区版编译器工具链与基础文档
企业研发版
面向中大型芯片设计企业,提供全流程软硬件协同验证与分布式云算力保障。
- 突破 100M+ 门级高并发软硬件仿真
- 片上网络 (NoC) 与互联协议精准建模
- 专属高性能云端弹性仿真调度池
- 专属半导体现场应用工程师 (FAE) 支持
私有化超算集群版
专为头部半导体厂商量身定制,支持客户自建机房完全物理隔离部署。
- 支持百亿级晶体管分布式协同集群
- 完全适配企业私有 PDK 与硬件库
- 完全物理隔离数据安全合规架构
- 定制编译代码生成器与算子优化库
来自一线半导体工程师的技术见证
严谨的数字前端、系统软件架构师与底层编译器工程师的使用实感。
“在设计多核张量微架构时,互联死锁检测一直是噩梦。该平台提供的片上网络时钟精确模型,帮助我们在编写 RTL 代码前精准重构了路由仲裁逻辑,节省了数月仿真排查。”
“平台内置的编译器套件极大平滑了硬件团队与软件开发者的协作断层。我们得以在芯片回片前 3 个月在虚拟靶场上运行完整的框架推理测试,软件交付节奏完全掌握。”
“功耗热点预测的准确度令人惊讶。结合实际模型任务轨迹,我们提前找出了时钟门控覆盖率不足的逻辑区块,确保了首版物理设计完全符合能效指标。”
半导体前沿与平台研发进展
深度解析异构计算拓扑、先进互联协议演进与底层编译理论。
RISC-V 矩阵扩展指令定制:从微架构到算子编译全链路
详解如何利用平台的敏捷工具链在 48 小时内定义自定义硬件原语并生成配套的 LLVM 编译器前端支持。
阅读全文与技术白皮书 →
技术问答与系统部署指引
关于云端安全性、PDK 支持库与异构硬件兼容性的权威解答。
平台如何保证芯片设计企业核心 RTL 源码与专有知识产权(IP)的安全性?
是否支持主流晶圆代工厂(如 TSMC、SMIC)的成熟与先进制程 PDK 物理库?
如何实现已有深度学习模型(如 PyTorch、ONNX 格式)到自定义芯片的无缝适配?
云端仿真沙盒与本地硬件仿真加速器(Hardware Emulator)如何桥接?
即刻接入 AI 芯片研发平台,加速硅基创新
预约云端沙盒试用节点,获取包含异构拓扑规范、编译器架构参考与全套仿真测试用例的芯片研发白皮书。